我用一顿饭劝退了一个想开 Token 工厂的算力老板
几千张卡、开源模型、开源引擎,拼起来不就是印钞的 Token 工厂?那顿饭我给他拆了三层账:芯片一代差 10 倍,同样的硬件和模型,推理系统还能再差 10 倍,标品市场里效率差一截就是生死。再讲了 1987 年只代工不设计的台积电,和为什么需求最火的文生视频,我们碰都不碰。
11 分钟阅读
68 篇文章
几千张卡、开源模型、开源引擎,拼起来不就是印钞的 Token 工厂?那顿饭我给他拆了三层账:芯片一代差 10 倍,同样的硬件和模型,推理系统还能再差 10 倍,标品市场里效率差一截就是生死。再讲了 1987 年只代工不设计的台积电,和为什么需求最火的文生视频,我们碰都不碰。
一个我预期一夜跑完的任务,连着三天在原地打转。折腾完 harness 才发现不怪我:Codex 里的 GPT-5.5 被人扒出思考 token 恒定停在 516,平均思考长度从 268 跌到 107。同一周,Claude Code 被逆向出一段专门给中国用户打隐形标记的代码。付了顶配的钱,拿到的却是一个你完全不知道它状态的黑盒。
GPT 5.5 发布那天,一夜之间 Codex 里就能选了。这次 5.6,三档规格、benchmark 漂亮,我去切模型,下拉框却是空的——只给 20 家合作伙伴,每进一个还要美国政府审批。前阵子我还在担心最强的智能开始论钱,现在我得收回一半:钱能买到的智能,已经算是公平的智能了。
我们在推理引擎上研究三周,换来几个点的效率提升。某天早上上线,第二天它就变成了报表上的利润。这条从技术到利润的链,被 token 经济压成了史上最短的一条:智谱半年股价八倍,OpenAI 靠 GPT-5.5 把 Codex 拉到 500 万周活,MiniMax 一度超过百度又迅速回落。捧你和弃你,用的是同一种速度。
用 agent 从零做推理引擎,项目越探索越乱,模型表现肉眼可见地变差。后来每次的解法都一样:停下来重新定义目标,开新 repo 重来,同一个模型判若两人。微软模拟了 20 万场对话得出同一个结论:模型走错路,自己不会回头。
一个朋友用模型做小工具,觉得已经够牛了;任务一复杂,就开始反复被告知「我搞定了」但其实没搞定。这背后是一个正在发生的分叉:benchmark 分数挤在天花板、彼此快测不出差异,真实体感却越拉越开。会解最难的题、能可靠办成一件糙活、会探索没有标准答案的问题,正变成三种不同的能力。而最要紧的那一维,恰恰最难测、也最难练。
Opus 4.8 在研究和工程任务上连着让我失望,这些活我全转给了 GPT 5.5。但复盘下来,这不是 Claude 一家的问题。从英伟达、AMD 差点破产,到智谱掉队又翻身,顶尖模型一直在风水轮流转。别赌谁最强,赌谁还在牌桌上。
大家算 token 成本,习惯盯 TTFT、TPOT、吞吐速率。真正让账单差出 10 倍的是 KV cache 有没有命中。模型、服务端、用户三层都得对得上。
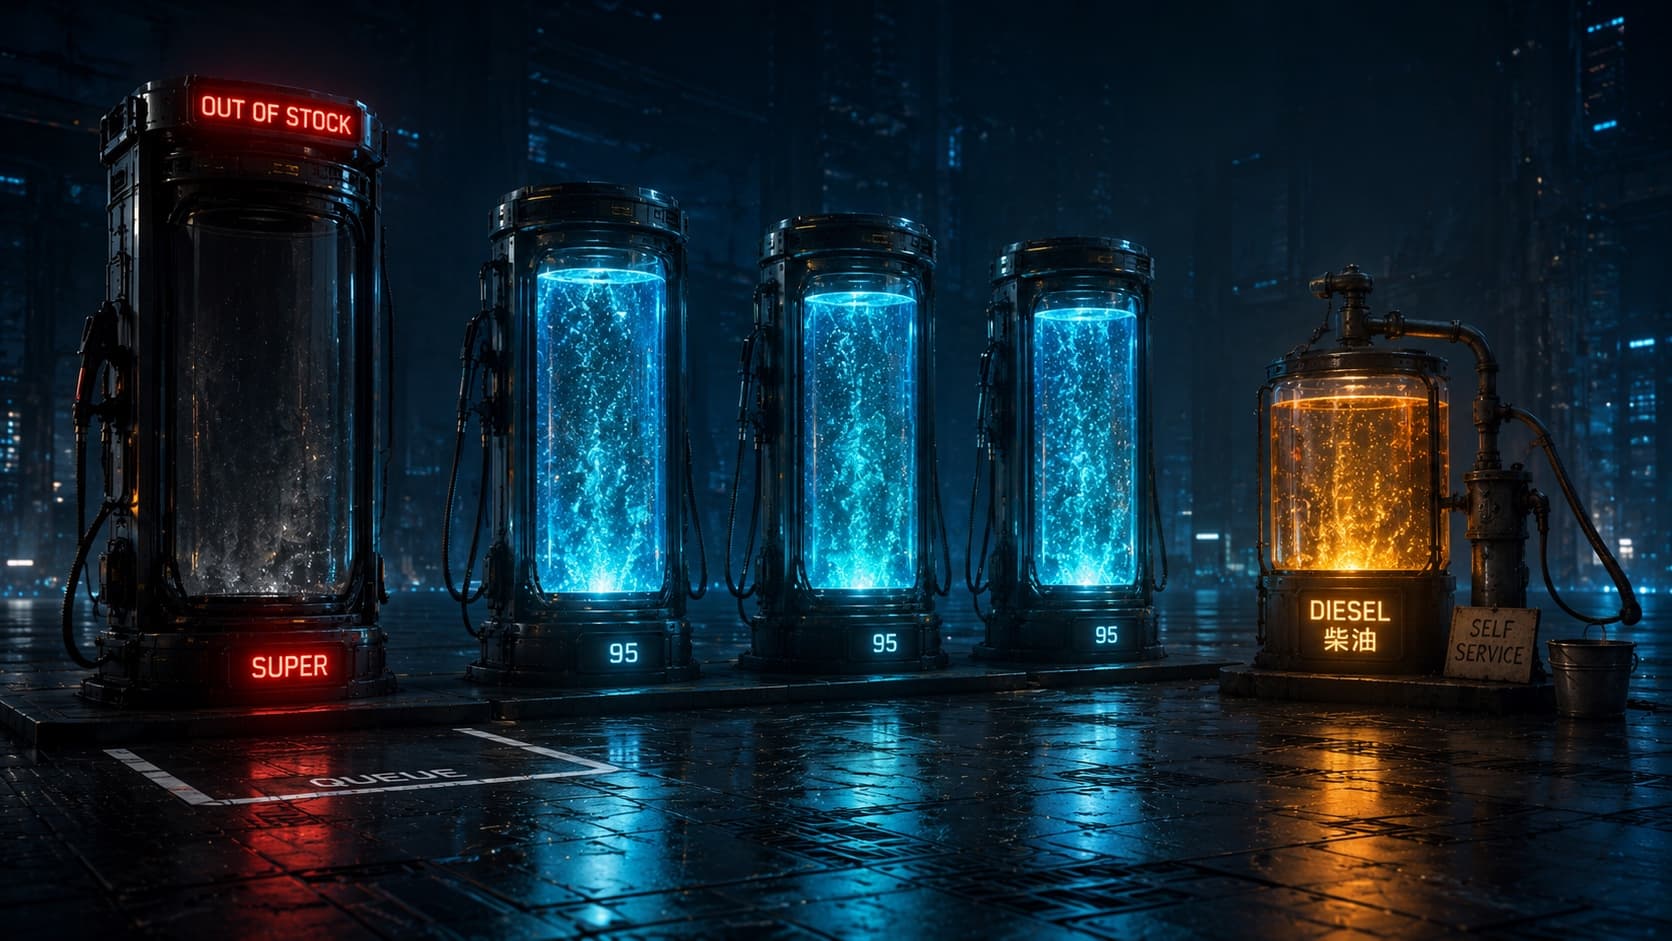
GPT-5.5、Opus 4.7 一档需求几乎无限,中等模型断档,中低端算力大量闲置。Token 经济听起来像卖电力,其实更像加油站:98 号汽油断货了,柴油桶装满了但需要自助,95 号装满了但空置。
上个月写了'无知是优势',这个月被 agent 连坑四次:性能虚高几十倍、实验机被删成砖、优化原地打转、目标太高交付不了。今天修正一下:无知让你敢试,常识让你不被骗。
Gemini 3.5 Flash 发布会几乎不讲智能,智谱 GLM-5.1 高速版冲到 400 token/s。背后是同一个故事——推理速度跨过 5 倍那条线之后,模型解锁的就是另一类产品了。
今天去上海 AMD 开发者大会。2000 多人挤进现场,AMD 把两个开发者奖之一颁给了一个不会写代码的人,他靠 agent 把东西用 Rust 重写做出了性能优化。一年前大家还在愁需求,半年过去所有人见面第一句都是:再给我点货。
Codex 上了 /goal 我用了几周。Claude Code 最近几天也跟着上,我把手头几个 Codex 没搞定的任务挪过去试,结果反差太大,值得记下来。
最近做了几个 AI 内容批量化的项目,发现一件之前没算明白的事:从一个能跑的 demo 到一条全自动产线,时间是 3 倍起,不是 50%。多出来的两个小时全在质检和重试上。也是这一趟让我看明白,中等智力模型和本地化算力到底应该用在哪。
韩国总统府提议把 AI 超额收益做成全民分红那天,三星工会还在谈罢工。这件事是 AI 冲击下三道题里的中间一道。前面有一道失业题,后面还有一道更深的:工作不再定义价值之后,人靠什么继续走。
从 GitHub Copilot 到 Claude Code 走了五年。方向印证得越彻底,最早笃定方向的那批人活得越艰难。小模型、工作流、独立 IDE,一层一层被基础模型吞掉。剩下还能卖的东西其实清晰,只是不再叫软件。
朋友问我要不要接 AI 变革专家的 offer。聊完三个小时,我把判断写下来:尖兵阶段不要省钱、不要碰 IDE、不要让 agent 黑盒化。GPT-5.5 发布两周,剩下 10 周世界会被一批意想不到的成果震撼。
朋友问 Vibe Coding 该从哪开始用。两条路:从工作切入,或从数字身份切入。前提是发出去的必须是真实的你——互联网有记忆,Kevin Hart 翻出来的旧推是十年前的。
看完 DeepSeek 估值 3000 亿的融资,我并不意外。真正震到我的是另一件事——梁文锋掏了 200 亿,按自己定的高估值跟外部投资者一起进了同一轮。这种事情我从业以来没见过。
用 Codex APP 的自动化做了两天,烧了一个 Pro 账号,进展微乎其微。换到 Codex CLI 的 Goal 功能就立刻顺了。一开始以为是模型变蠢,后来想明白:是 agent 形态在定型,人不该再被绑在屏幕前。
我做了七百轮 AI Infra 实验,三十五个小时全被环境启动吃掉。一开始还以为是 GPT-5.5 fast 模式不够快,后来发现根本不是模型在思考,是模型在等 CPU。Intel 已经把服务器 CPU:GPU 配比从 1:8 收紧到 1:1。
Claude 在任务跑到一半的时候让我「睡一觉」,GPT-5.5 探一下就把方向关了。用了一周新模型我反而看清一件事:模型再强,跟它协作的那部分还是得人来扛。
代号 SPUD 的 GPT-5.5 上线两周,我把 Claude Code 卸得差不多了。让我意外的不是它强了几个百分点,是几个老短板一次性补完之后,agent 的设计哲学第一次变得清晰。
60 人公司一夜被封号、110 人公司账号封了 API 还在扣钱、Altman 家被扔燃烧瓶、Meta 搞 token 烧钱排行榜——AI 时代的权力问题已经摆到桌面。这一波重新分配里,公司、国家、个人各自该把什么握在自己手里?
前几天大会上聊 AI for science,有人提到三堵墙:付费墙、湿实验墙、感知墙。陶哲轩说我们正在经历智能的哥白尼革命,人不再是智能的中心。全球 880 万全职科研人员,AI 之后可能是几亿。门外汉先冲进来了,但真正的瓶颈不在模型。
23 岁的 Liam Price 让 GPT-5.4 Pro 在 80 分钟里破了 Erdős 困了人类 60 年的猜想,陶哲轩说大家在第一步就集体走偏了。同一周电梯里两个陌生人在谈裁员。AI 把过去最贵的资源给到了每个个体,问题只是你拿来给世界多加点东西,还是把交差做得更漂亮。
GPT-5.5 今天发了,距 5.4 才一个半月。Opus 4.7 上周发了,距 4.6 才两个月。更逗的是 GPT 终于说人话了,Opus 反而开始不说了。这个节奏下,判断本身的半衰期都变短了。
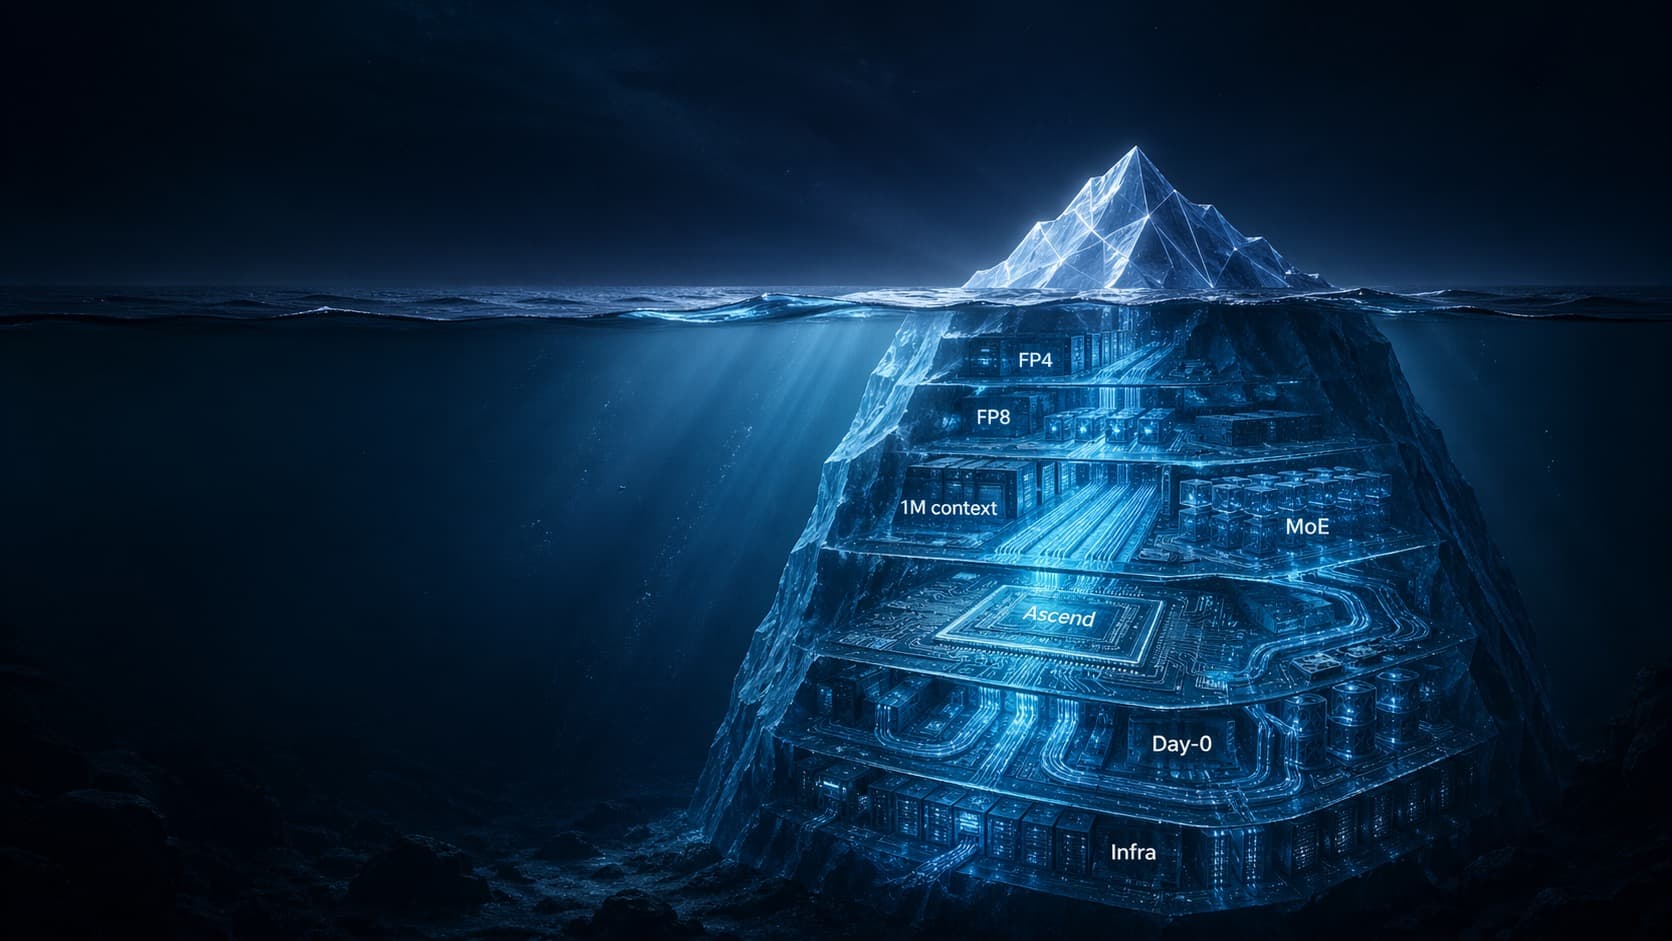
V4 能力卡在 Opus 4.6 一档,但把 FP4 推到生产、百万上下文做成默认、国产芯片 day-0 适配,对所有做推理 Infra 的人都是灾难。加上 GPT-5.5、Vision Banana、LPM 1.0,这一周挤进来的新东西比过去一整个季度都多。
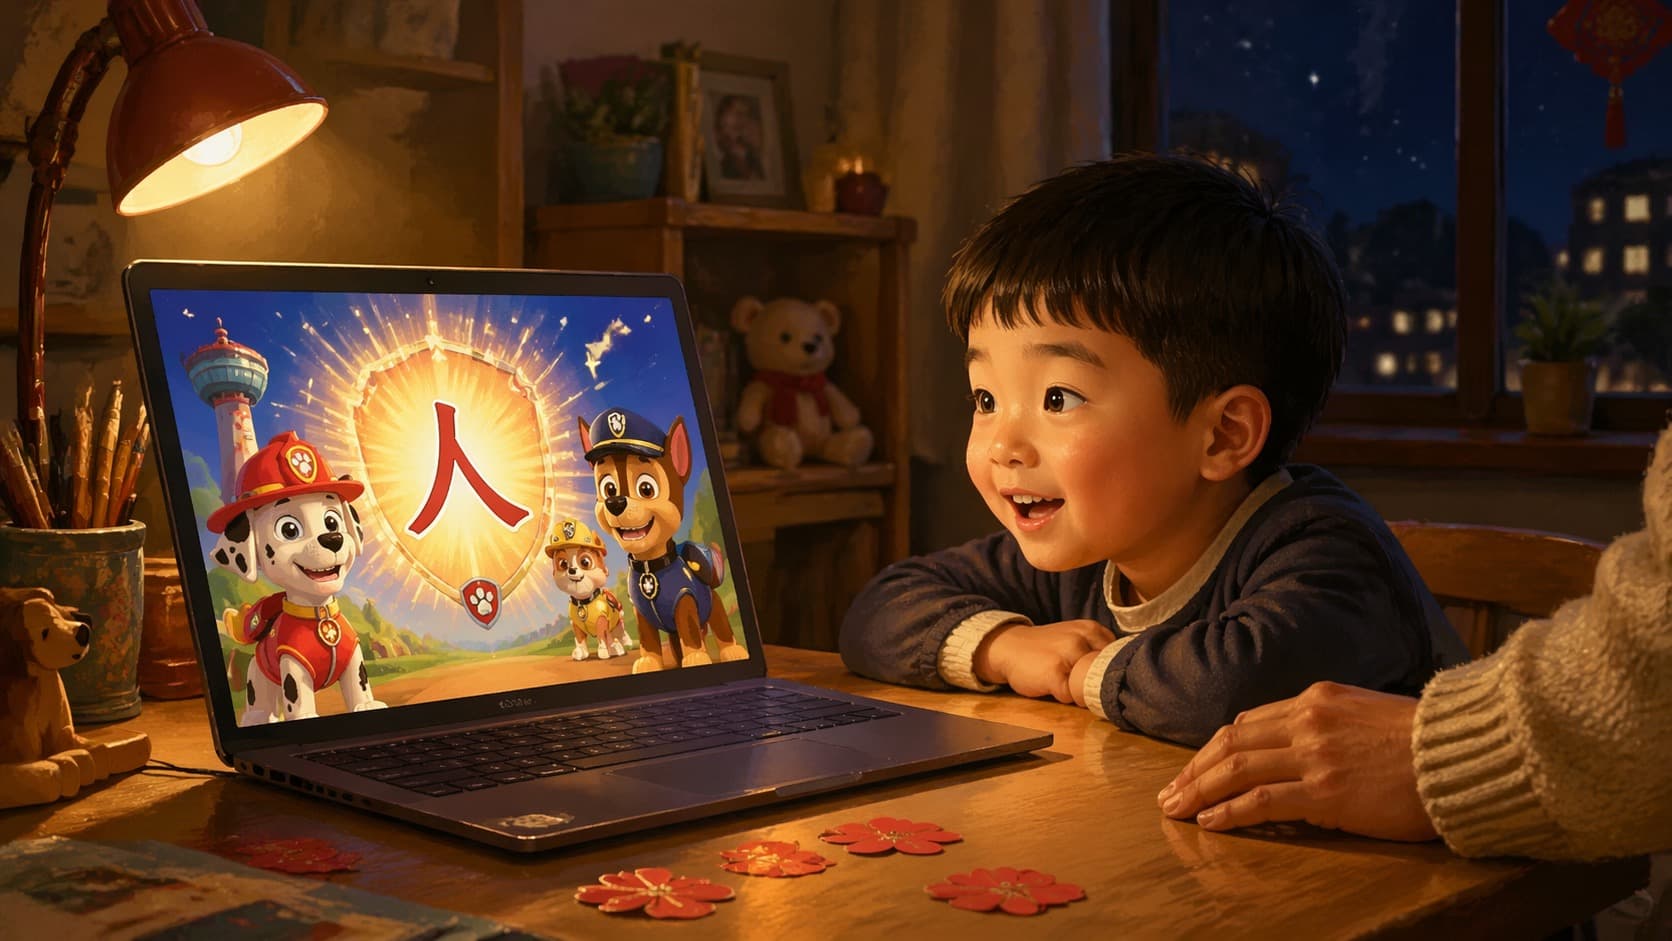
起因是儿子小声跟我说,学校里认字能得小红花,他经常拿不到。我用 coding agent 给他做了一个汪汪队 IP 的认字游戏,前后一天半。最意外的不是儿子玩到不肯走,是我妻子的反应——她第一次真正感觉到,AI 这东西落到了我们家客厅里。
价格本来是用来调节供需的,大模型这件事偏偏卡在一个奇怪的位置——供给被芯片管制锁死,需求被三类用户拉成完全不同的形状。Coding Plan 这种当年看起来理所当然的模式,现在反而被反复挑战。
给一个 idea 点个赞、收下一个 star 现在是秒级的事。但把想法做到真正能用、经得起挑刺,中间那段最长最枯燥的路,vibe coding 并没怎么缩短。写一写我最近的切身感受,也翻了翻乔布斯和张小龙身上绕不开的那个共同点。
Karpathy 自己都不用 vibe coding 这个词了,Amazon 一次宕机之后干脆给初级工程师的 AI 代码加了 senior 签字关。我从自己的日常用法讲起,聊聊这个工具真正改变的四件事——宽度、速度、质量,和那件永远没动过的责任归属。
国民党新主席访问大陆,回台湾不找主流媒体,跑去跟网红直播。她跟雷军见面说自己老公全身都是小米。这种人让我想起春秋末期。礼崩乐坏的另一面是百家争鸣,现在也一样。
昨晚 Opus 4.7 发布,我就没睡成。起来试了试,顺手给 OpenClaude 提了几个 PR 合进了主干,还把 Strix Halo 上 Qwen3-30B 的 prefill 推到了接近 DGX Spark 的水平。Agent 够强之后,一个人能同时做几件事,变成了一个挺具体的问题。
Anthropic 搞实名认证,中国这边炸锅了。但说实话这事一点都不意外。AI 行业从 2023 年开始就是战时状态,芯片禁令、军事合同、模型封锁,跟工业革命那会儿的清朝太像了。
朋友圈又在刷 GPT-6 发布了。假信息有观众,真信息是细分市场。AI 让这件事严重了,不是变轻了——这也是为什么我最近把团队又推回了 Claude Code。
一个是 Claude Code 修不好自己家的 Chrome 插件,绕了四个小时;一个是小红书怎么发都被软限流。AI 没把工作从失败变成成功,它只是让失败跑得更快——这反而是它最值钱的地方。
GitHub 在小红书化,公众号在 GitHub 化。饺子馆老板 vibe coding 写 skill,好莱坞明星当 GitHub 第一作者,朋友圈流行把同事蒸馏成 skill。不过 skill 可能不是重点,agent 互通才是。
Aima Service 重构复盘。产品像急诊室,用户不在乎装修,只在乎医生能不能看病。Claude Code 和 Codex 交替跑了一周多,130 万行代码落地。回头一看,代码量这条护城河可能已经不在了。
HappyHorse 一夜登顶视频生成排行榜,但没人知道它是谁的。域名被抢注、HuggingFace 被占位、来源众说纷纭。比这些热闹更值得聊的,是文生视频私有化需求背后的硬件和商业逻辑。
调研文生视频的时候发现,中国模型在语言模型开源社区的统治力并没有延伸到所有地方。回头看这三年,从 LLaMA 到千问到 DeepSeek,开源社区经历了什么?现在又在等什么?
编程和内容创作是两条正在分叉的路。Seedance 2.0 的 API 一开放,朋友圈全炸了。Agent 对 Agent 的效率是开会的一百倍。打球的时候终于不用谈生意了。
张雪为了把公差从五丝压到三丝,自己扛供应链的试错成本。祝铭明十年死磕 AR 眼镜,中间靠音箱续命。这些人身上有一种共同的东西,不是聪明,是热情。AI 恰好在放大这种东西。
帮人装了一圈小龙虾之后的想法:OpenClaw 的体验取决于背后模型的执行力,而当前最好的模型体验在 Claude Code 这样的 coding agent 上。
一个技术外行用Claude Code做了个实验:10天堆出30万行代码,发现走不通,推倒重来。48小时后,不到1万行代码,端到端跑通了。代码是负债,不是资产。