我用一顿饭劝退了一个想开 Token 工厂的算力老板
几千张卡、开源模型、开源引擎,拼起来不就是印钞的 Token 工厂?那顿饭我给他拆了三层账:芯片一代差 10 倍,同样的硬件和模型,推理系统还能再差 10 倍,标品市场里效率差一截就是生死。再讲了 1987 年只代工不设计的台积电,和为什么需求最火的文生视频,我们碰都不碰。
11 分钟阅读
7 篇文章
几千张卡、开源模型、开源引擎,拼起来不就是印钞的 Token 工厂?那顿饭我给他拆了三层账:芯片一代差 10 倍,同样的硬件和模型,推理系统还能再差 10 倍,标品市场里效率差一截就是生死。再讲了 1987 年只代工不设计的台积电,和为什么需求最火的文生视频,我们碰都不碰。
我们在推理引擎上研究三周,换来几个点的效率提升。某天早上上线,第二天它就变成了报表上的利润。这条从技术到利润的链,被 token 经济压成了史上最短的一条:智谱半年股价八倍,OpenAI 靠 GPT-5.5 把 Codex 拉到 500 万周活,MiniMax 一度超过百度又迅速回落。捧你和弃你,用的是同一种速度。
大家算 token 成本,习惯盯 TTFT、TPOT、吞吐速率。真正让账单差出 10 倍的是 KV cache 有没有命中。模型、服务端、用户三层都得对得上。
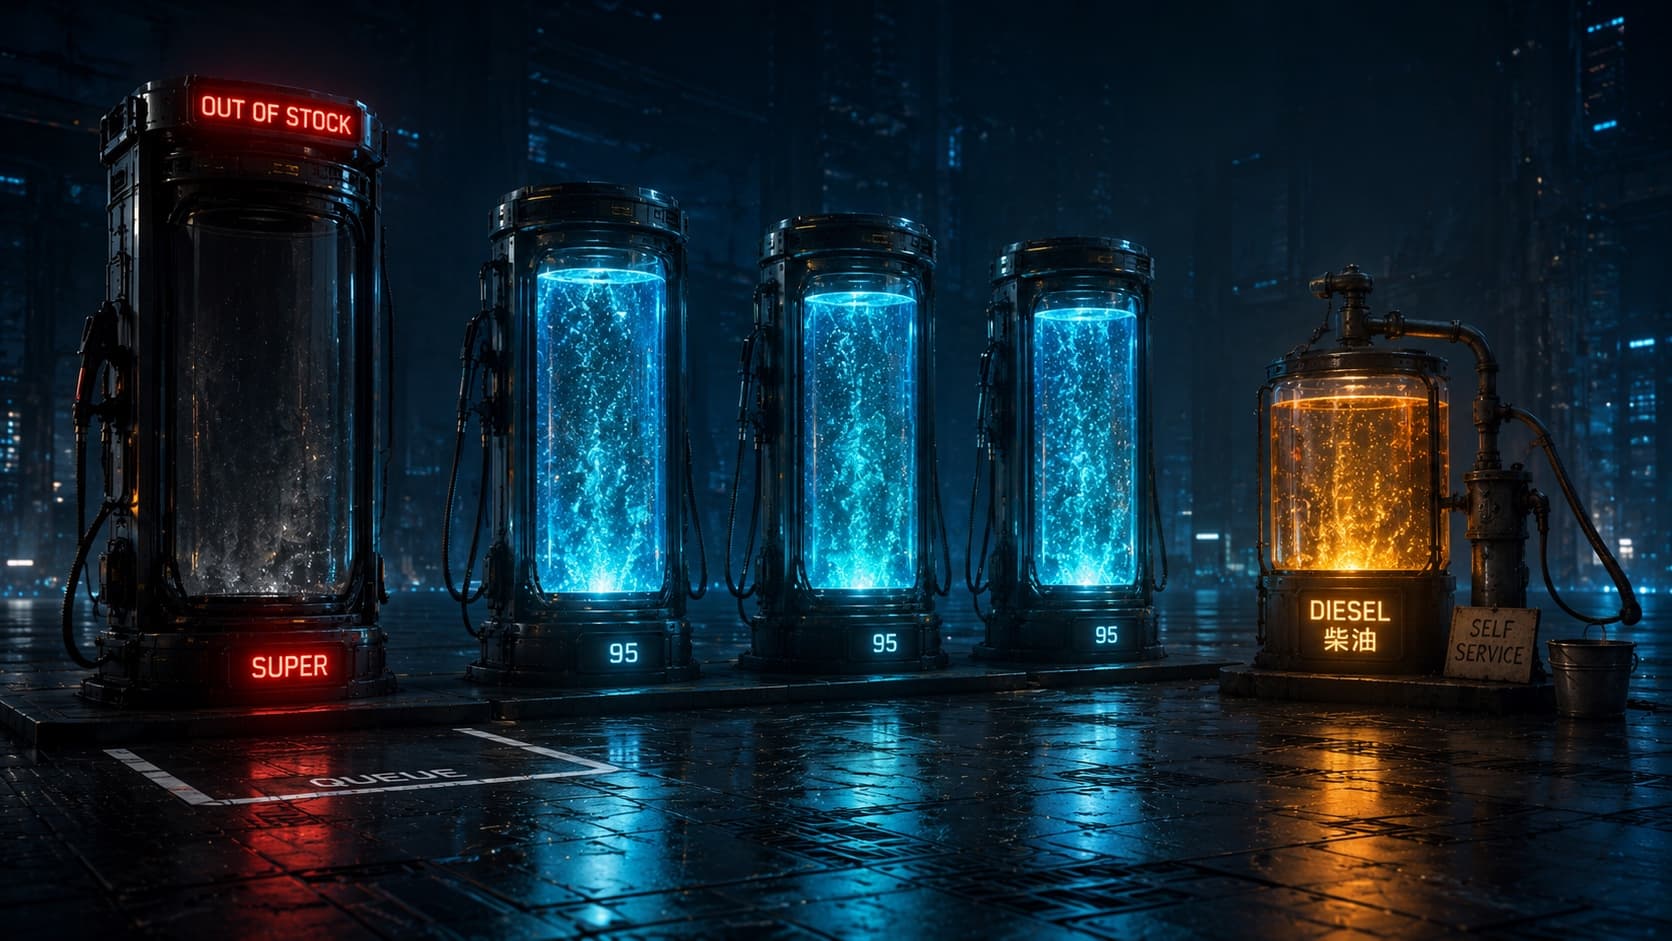
GPT-5.5、Opus 4.7 一档需求几乎无限,中等模型断档,中低端算力大量闲置。Token 经济听起来像卖电力,其实更像加油站:98 号汽油断货了,柴油桶装满了但需要自助,95 号装满了但空置。
Gemini 3.5 Flash 发布会几乎不讲智能,智谱 GLM-5.1 高速版冲到 400 token/s。背后是同一个故事——推理速度跨过 5 倍那条线之后,模型解锁的就是另一类产品了。
我做了七百轮 AI Infra 实验,三十五个小时全被环境启动吃掉。一开始还以为是 GPT-5.5 fast 模式不够快,后来发现根本不是模型在思考,是模型在等 CPU。Intel 已经把服务器 CPU:GPU 配比从 1:8 收紧到 1:1。
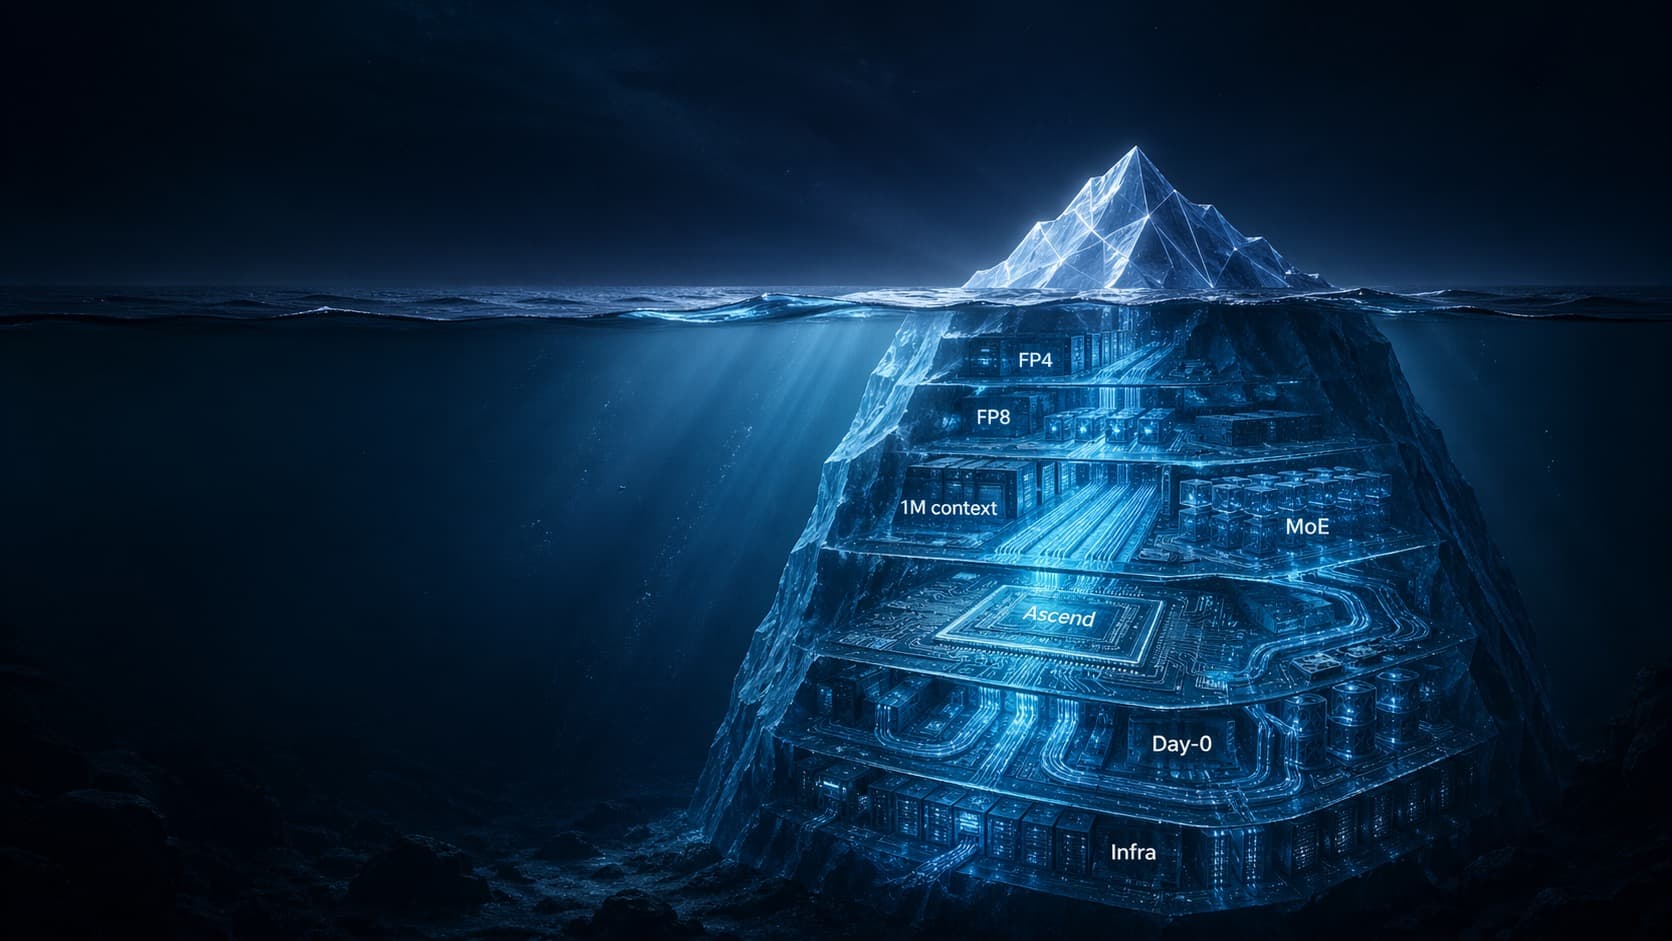
V4 能力卡在 Opus 4.6 一档,但把 FP4 推到生产、百万上下文做成默认、国产芯片 day-0 适配,对所有做推理 Infra 的人都是灾难。加上 GPT-5.5、Vision Banana、LPM 1.0,这一周挤进来的新东西比过去一整个季度都多。