我用一顿饭劝退了一个想开 Token 工厂的算力老板
几千张卡、开源模型、开源引擎,拼起来不就是印钞的 Token 工厂?那顿饭我给他拆了三层账:芯片一代差 10 倍,同样的硬件和模型,推理系统还能再差 10 倍,标品市场里效率差一截就是生死。再讲了 1987 年只代工不设计的台积电,和为什么需求最火的文生视频,我们碰都不碰。
11 分钟阅读
推理 Infra、Token 经济与算力生意
几千张卡、开源模型、开源引擎,拼起来不就是印钞的 Token 工厂?那顿饭我给他拆了三层账:芯片一代差 10 倍,同样的硬件和模型,推理系统还能再差 10 倍,标品市场里效率差一截就是生死。再讲了 1987 年只代工不设计的台积电,和为什么需求最火的文生视频,我们碰都不碰。
我们在推理引擎上研究三周,换来几个点的效率提升。某天早上上线,第二天它就变成了报表上的利润。这条从技术到利润的链,被 token 经济压成了史上最短的一条:智谱半年股价八倍,OpenAI 靠 GPT-5.5 把 Codex 拉到 500 万周活,MiniMax 一度超过百度又迅速回落。捧你和弃你,用的是同一种速度。
大家算 token 成本,习惯盯 TTFT、TPOT、吞吐速率。真正让账单差出 10 倍的是 KV cache 有没有命中。模型、服务端、用户三层都得对得上。
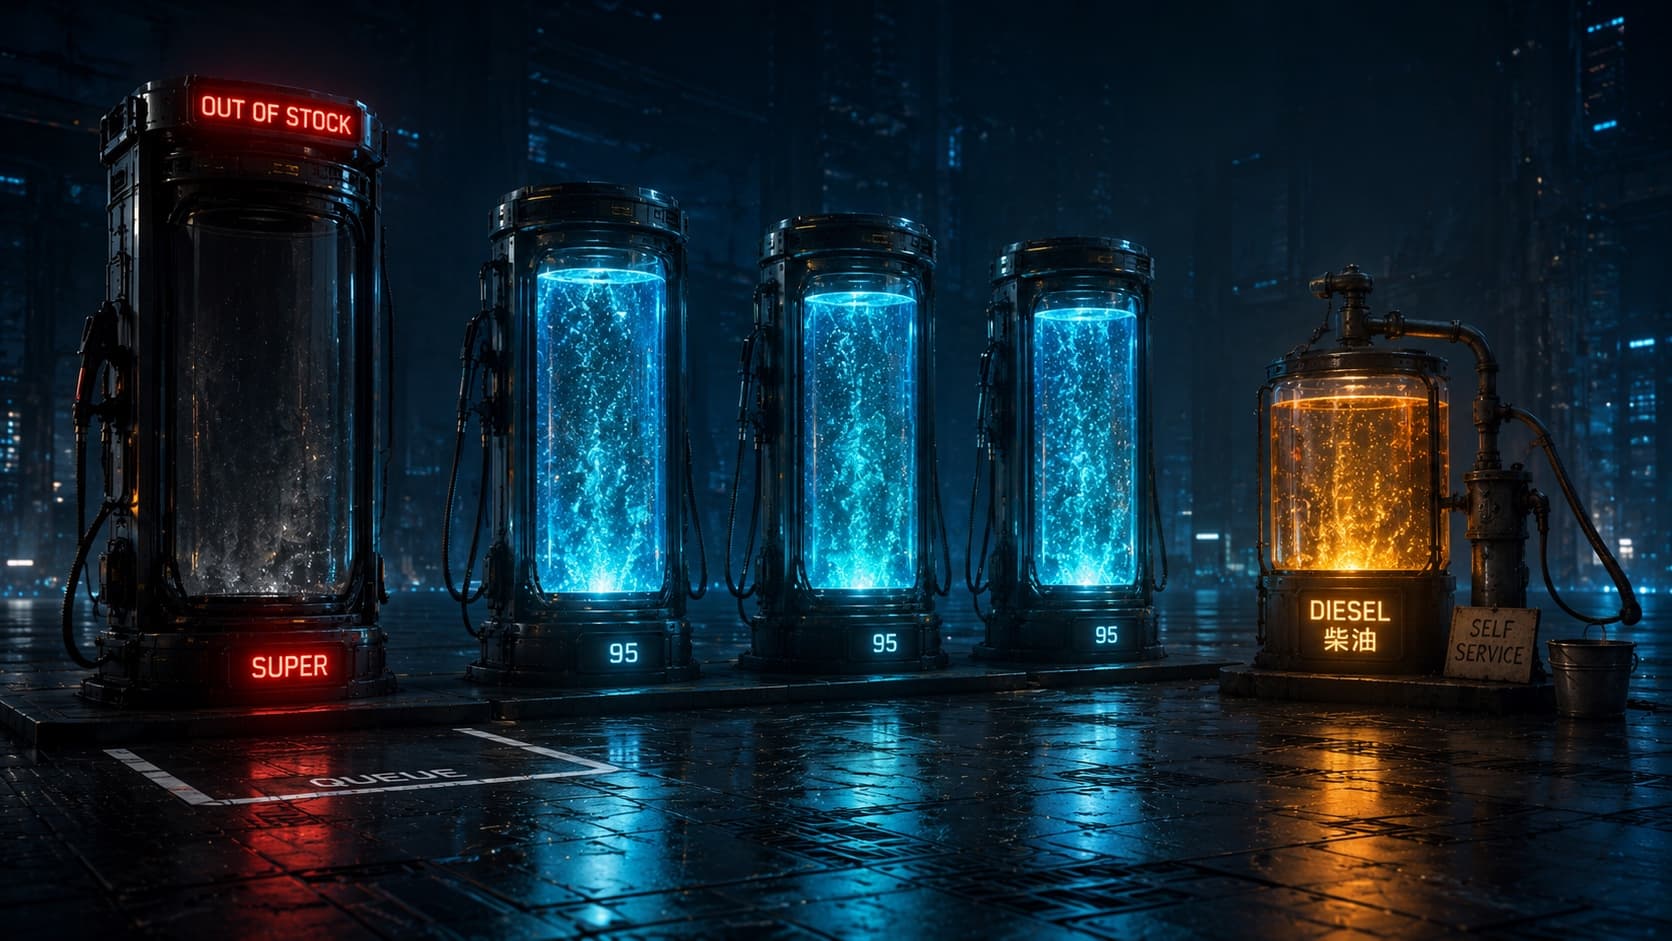
GPT-5.5、Opus 4.7 一档需求几乎无限,中等模型断档,中低端算力大量闲置。Token 经济听起来像卖电力,其实更像加油站:98 号汽油断货了,柴油桶装满了但需要自助,95 号装满了但空置。
Gemini 3.5 Flash 发布会几乎不讲智能,智谱 GLM-5.1 高速版冲到 400 token/s。背后是同一个故事——推理速度跨过 5 倍那条线之后,模型解锁的就是另一类产品了。
我做了七百轮 AI Infra 实验,三十五个小时全被环境启动吃掉。一开始还以为是 GPT-5.5 fast 模式不够快,后来发现根本不是模型在思考,是模型在等 CPU。Intel 已经把服务器 CPU:GPU 配比从 1:8 收紧到 1:1。
做完 AIMA 管理层和售后层之后我发现还差一块。Ollama 太傻、llama.cpp 精度被自己的格式吃了、vLLM 又太重。市面上没有现成的解,那就自己来。
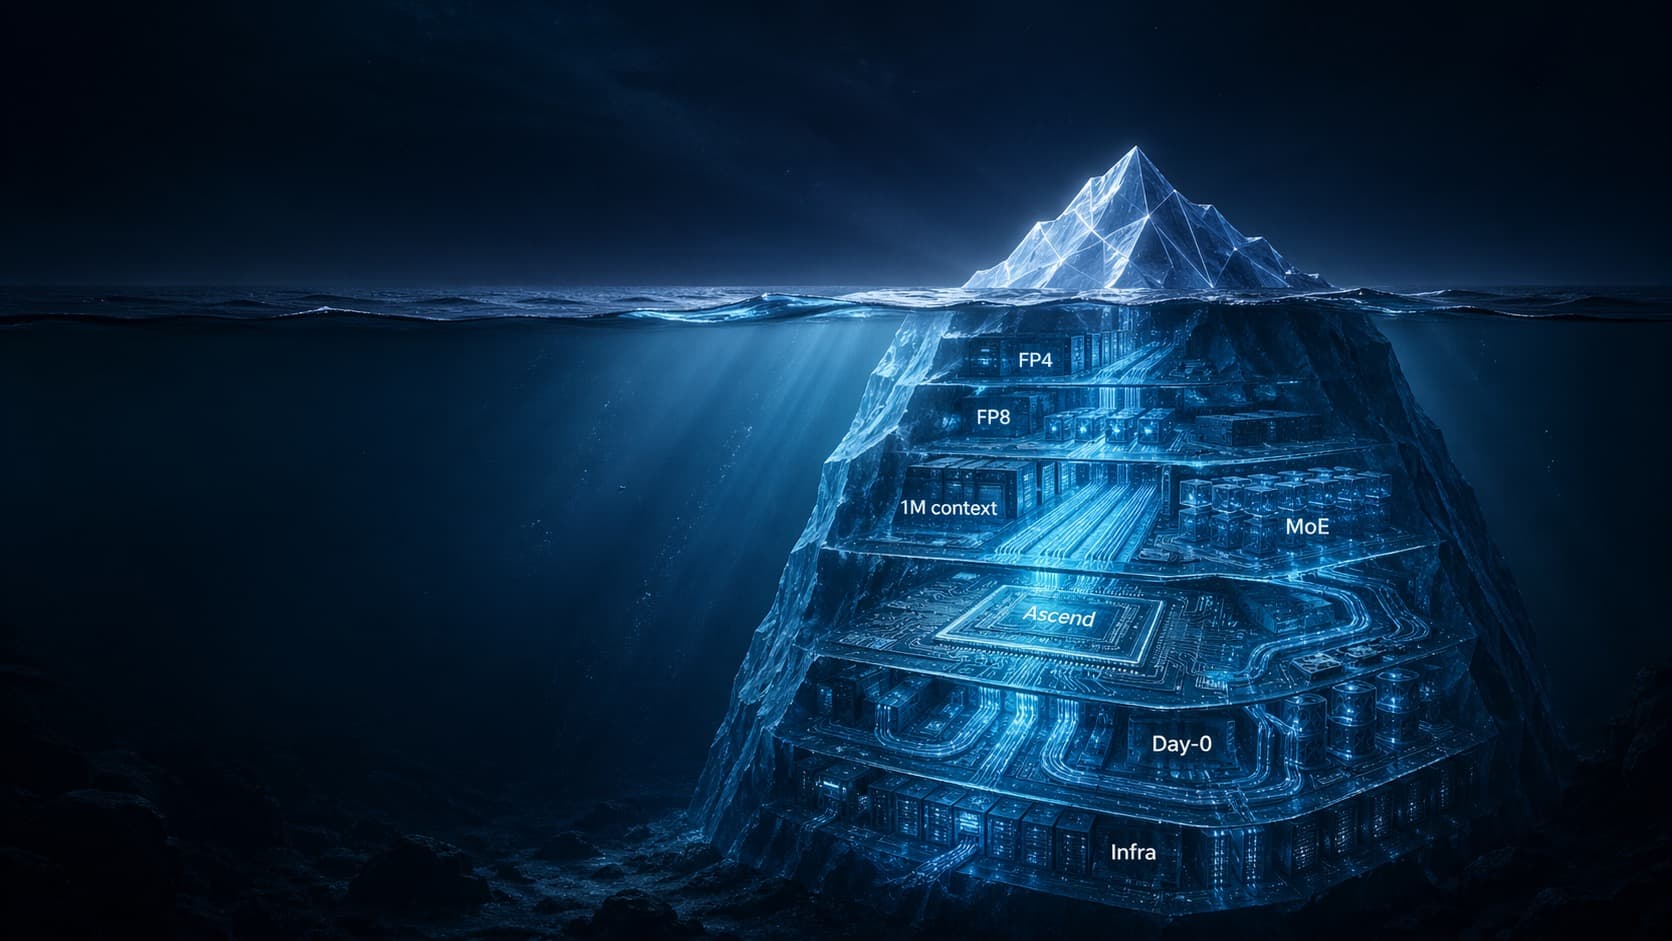
V4 能力卡在 Opus 4.6 一档,但把 FP4 推到生产、百万上下文做成默认、国产芯片 day-0 适配,对所有做推理 Infra 的人都是灾难。加上 GPT-5.5、Vision Banana、LPM 1.0,这一周挤进来的新东西比过去一整个季度都多。
价格本来是用来调节供需的,大模型这件事偏偏卡在一个奇怪的位置——供给被芯片管制锁死,需求被三类用户拉成完全不同的形状。Coding Plan 这种当年看起来理所当然的模式,现在反而被反复挑战。
折腾两天做不出来的工具,换个模型半小时搞定。电脑登不进去,一个 AI 智能体半小时帮我修好。后来我做了 Aima Service,想让每台设备在出问题时都能有个 AI 来帮忙。
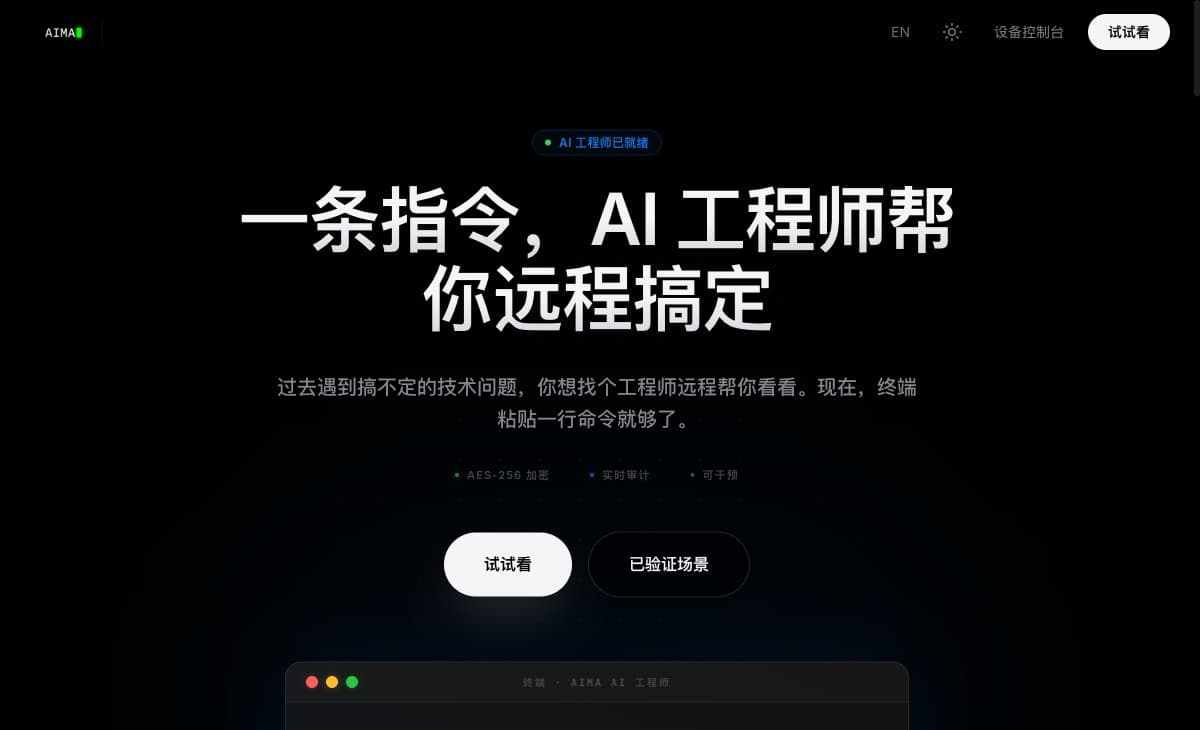
不用远程协助了。打开终端,粘贴一行命令,输入邀请码,AI 自动帮你装好 OpenClaw、连上大模型、接入飞书。全程你只需要回答几个问题。
一台AI服务器买回来调好,三个月后价值可能只剩一半。我们开源了AIMA——一个Go二进制,57个MCP工具,用YAML知识库驱动异构硬件上的AI推理部署。
新文章发布时第一时间通知你,不会发送垃圾邮件。
仅用于博客更新通知,随时可以取消订阅。